Gezdiren editoryal görseli
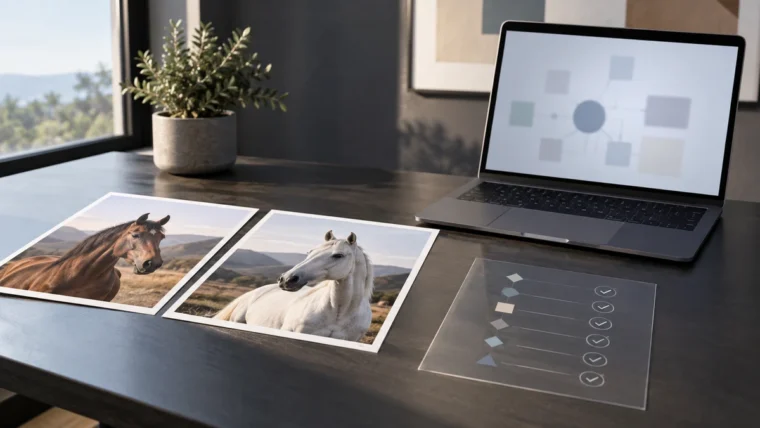
Bir yapay zekâ sistemi iki görselden birini seçiyor. Sonra nedenini soruyorsunuz; anatomiden, kompozisyondan, temizlikten söz eden muntazam bir cevap geliyor. İnsanın ilk refleksi, cevabın ayrıntılı olmasını güven işareti saymak. Oysa burada sorulması gereken daha basit bir soru var: Sistem gerçekten bu ölçütlerle mi seçti, yoksa seçimi yaptıktan sonra bize makul gelecek bir neden mi yazdı?
Osman’ın yakın tarihli X paylaşımındaki örnek, yapay zekâ tartışmasında çoğu kez kaçırdığımız ayrımı çıplaklaştırıyor. Hata yalnız yanlış sonuç değildir. Sonuç kullanılabilir olsa bile, sonradan üretilen açıklama seçimi yeniden üretmeye yarayan girdi ve ölçütleri vermeyebilir.
Bu ayrım küçük görünür, çünkü insanlarla konuşma alışkanlığımız yanıltıcıdır. Bir arkadaşımız bir fotoğrafı seçip gerekçesini anlattığında, en azından onun aynı karar anına eriştiğini varsayarız. Modelde ise çıktı ile açıklama arasında böyle bir zorunluluk yoktur. Bu alandaki araştırmalar, dil modellerinin ikna edici açıklamalar üretirken kararlarını etkileyen işaretleri güvenilir biçimde yansıtmayabildiğini gösteriyor. Böyle bir açıklama, hangi seçeneğin hangi girdi veya ölçüt yüzünden elendiğini sonradan kontrol etmeye yetmez.
Burada yaygın açıklama şudur: “Model halüsinasyon yaptı.” Doğru, fakat eksik. Halüsinasyon kelimesi meseleyi tekil bir yanlış bilgiye indiriyor. Oysa otomasyon kullanan kurumun derdi, hangi seçimin niçin yapıldığını sonradan sınayabilmektir. Seçilen görsel, reddedilen alternatifler, kullanılan ölçüt, skor veya insan müdahalesi kayda geçmiyorsa; hatalı bir seçimin hangi aşamada oluştuğu incelenemez.
Bu yüzden yapay zekâyı insan gibi konuşturarak denetlediğimizi sanmak tehlikeli. Konuşma çıktısı, hangi veriyle işlem yapıldığını, hangi eşiğin uygulandığını ve hangi insanın müdahale ettiğini taşımaz. Bir satın alma sistemi tedarikçiyi elediyse, “fiyat-performans daha iyiydi” cümlesi yeterli değildir. Hangi fiyat, hangi teslim süresi, hangi eşik ve hangi istisna? Bir işe alım taslağı adayı geriye attıysa, “uyum zayıftı” denemez; hangi ölçülebilir koşulun karşılanmadığı görülmelidir. Görsel seçimi bu büyük meselelerin oyuncak modeli sayılabilir.
OpenAI’nin halüsinasyon araştırması, sistemlerin belirsizlik yerine tahmini ödüllendiren düzeneklerde güvenle yanlış ifade üretebildiğini vurguluyor. Buradan çıkan sonuç, her model cevabına şüpheyle bakıp işi durdurmak değil. Bir öneri, çalışanların tartışabileceği başlangıç noktasıdır; karar ise yetki ve sonuç doğurur. Karar kaydı olmadan, iki gün sonra aynı seçimi neden yaptığınızı test edemezsiniz.
Karşı itiraz haklı bir sınır hatırlatıyor: Model açıklaması bazen gerçekten işe yarar. İnsan, seçimin kalitesini o açıklama sayesinde tartışabilir; hata da yakalayabilir. Fakat açıklamanın faydalı olması, onun olay kaydı olduğu anlamına gelmez. Bir satış temsilcisinin sonradan yazdığı toplantı notu da yararlıdır; ama takvim, teklif sürümü ve gönderim saati olmadan ispat değildir.
Bu nedenle yapay zekâ ile çalışan ekiplerin ilk sorusu “Bana nedenini anlat” olmamalı. “Bu kararı yeniden kurmamı sağlayacak hangi izleri tuttun?” olmalı. Girdi sürümü, araç çağrısı, seçim ölçütü, alternatifler, insanın son dokunuşu: bunlar gösterilebiliyorsa modelin açıklaması da faydalı bir yorum katmanı olur. Bu kayıtlar yoksa, bir itiraz geldiğinde ekip seçimi geriye doğru inceleyemez.
Bu nedenle her otomasyonda en azından girdi sürümü, uygulanan kural, alternatif ve insan müdahalesi saklanmalı. Bir itiraz, hata veya geri alma gerektiğinde ekip ancak bu dosyayla seçimi inceleyebilir; modelin açıklaması buna eklenen faydalı bir not olarak kalmalıdır.